最新ニュース·2026.10.31
Lauren Tan氏の講演「All Code Is Slop」の要点:AIの間違いは指示より仕組みで止める(Grok Botチームの実践)
最新ニュース·2026.11.17·最終検証: 2026.11.17·11 min read·
SETODEZA合同会社 CTO
岡山大学大学院でAIを研究し、修了後はフリーランスのエンジニアとして独立。延べ利用者5,000人超のスマホアプリ「ぐらごる」を開発したほか、Web・スマホ・デスクトップのアプリを受託で手がける。SETODEZA合同会社CTOとして、設計からテストまでAIを組み込んだ開発を実践。せとうちAIではAIツールの検証と執筆を担当。
AIエージェントに作業を任せると、同じ間違いが何度も出ることがあります。そのたびに指示のファイルに1行ずつ足していくと、ファイルは長くなりますが、間違いが止まるとは限りません。
- この記事の対象
Claude Code などの AIエージェントに作業を任せ始めたが、同じ間違いが何度も出て、指示を書き足すだけでよいのか迷っている人(エンジニアに限らない)
- 結論
- 講演の要点は「同じ間違いが続くなら、規則に1行足すのではなく、決定的なチェック(コード・lint)にする」こと
- 講演で示された数字(講演の前の月にチームで約11,000件の PR、revert 約0.5%)は、チーム自身の体験談で、品質全体を示すものではない
- Claude Code では、CLAUDE.md は「文脈」、hooks と permissions の deny は「仕組み」として働く(2026年11月17日に確認した公式ドキュメント)
- まずは、2回目に出た間違いを「仕組みにできるか」で振り分けることから始められる
AIエージェントに作業を任せると、同じ間違いが何度も出ることがあります。そのたびに指示のファイルに1行ずつ足していくと、ファイルは長くなりますが、間違いが止まるとは限りません。
この記事では、Grok Bot のクライアントを作るチームの Lauren Tan(ローレン・タン)氏の講演の要点を、主催者のページと講演の文字起こしで確かめた範囲でまとめます。本人が X で公開を告知し、中国語・韓国語の紹介動画も出ている講演です。あわせて、その考え方を Claude Code の設定に置き換える方法を、2026年11月17日に確認した公式ドキュメントをもとに整理します。講演はソフトウェア開発の話です。エンジニア以外の業務に当てはめる部分は、せとうちAI の考えとして分けて書きます。
Lauren Tan 氏の講演「All Code Is Slop (Except Mine)」とは
「All Code Is Slop (Except Mine)」は、Grok Bot のクライアントを作るチームが、AIエージェントにコードを書かせながら品質を保つために何をしてきたかを話した、約17分の講演です。主催者のページでは、AI Engineer CODE 2026 の 2026年11月11日の講演とされています。動画は YouTube で公開されています(下の「出典」)。
- 話し手: Lauren Tan 氏。主催者の講演ページでは「Principal Engineer at SpaceXSI」、登壇者ページの所属は「SpaceX Super Intelligence」です。登壇者ページには、Netflix でエンジニアリングを率いたこと、Meta で React Compiler のコアチームにいたこと、Cursor のプラグイン pstack の作者であることが書かれています
- 扱う内容(主催者ページの説明文から): 自作のフレームワーク Dune、lint(コードの書き方を自動で調べる道具)によるガードレール、実行時と形式手法による検証、リリース後の自動テスト
- 説明文の前提: チームが約6か月かけて「エージェントに安全に変えさせられること」「コードベースが許すこと」「変更が効いたかの確かめ方」を学んできた、という話です
講演で示された数字と、その読み方
講演で示された数字は次のとおりです(講演の文字起こしと主催者ページで確かめました)。
| 数字 | 何の数字か |
|---|---|
| 約11,000件 | チームが講演の前の月に本番に出した PR(プルリクエスト。コードの変更の単位)の数 |
| 約0.5% | PR のうち、あとで取り消し(revert)された割合。相対的に下がり、この値で安定しているとのこと |
| 約227人 | 10月に1件以上 PR を出した人の数 |
| 数千件 | タン氏本人が1か月に本番に出した PR。講演では「3,000」と話していますが、文字起こしの誤りの可能性を指摘する要約もあります |
読むときは、次の点に注意してください。
- これらはチーム自身の体験談で、第三者が検証した調査ではありません
- revert の割合は「取り消されたかどうか」だけの数字で、品質の全体を示すものではありません
- 講演の中で「トークン(AI が処理する文字の単位)の約7割を検証に使う」という数字が出てきますが、これはタン氏本人の数字ではなく、紹介された別の人(Cindy 氏)の投稿の数字です。タン氏本人は「トークンの多くは検証に使っている」と話していますが、割合は出していません
講演の要点:同じ間違いは「規則に1行足す」より「決定的なチェック」に
講演の中心は、同じ間違いが続くなら、規則(エージェント向けの指示のファイル)に1行足すのではなく、決定的なチェックにできないかを考えるという考え方です。「決定的」とは、AI の判断に任せず、毎回同じように実行されて同じ結果になることを指します。タン氏は、コードにしておくほうが再現しやすく、信頼もしやすいと話しています。
講演では、この順番を「逆ピラミッド」として説明しています。
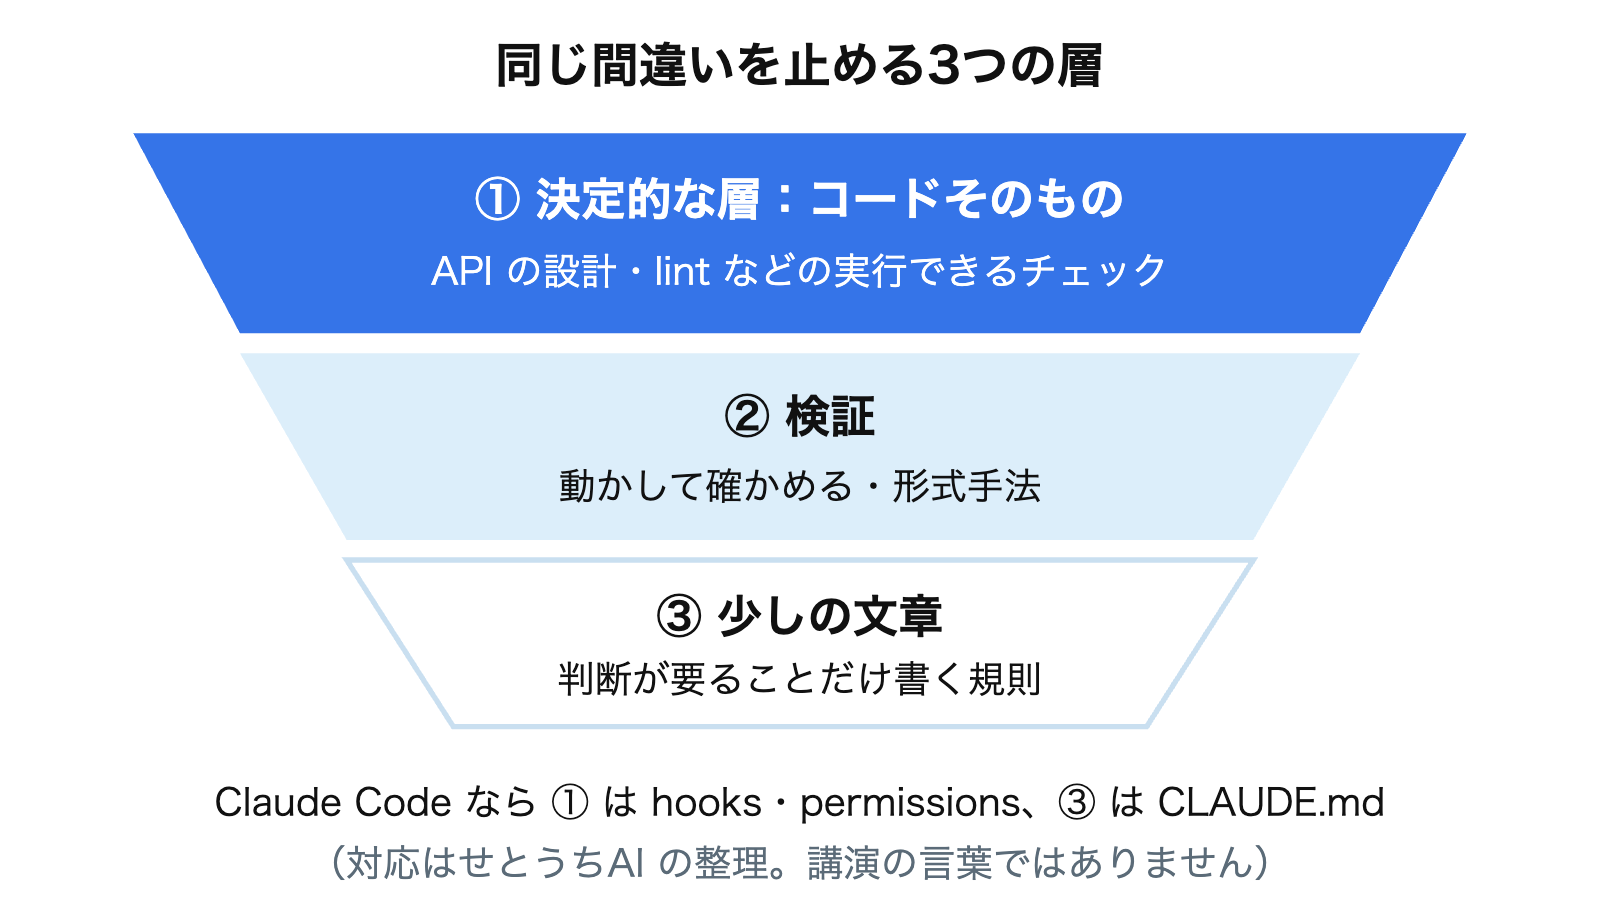
- 決定的な層(講演では2層): コードそのもので防ぐ。間違いが起きないように API(部品の使い方の決まり)を設計し、lint などの実行できるチェックで止める
- 検証: 実行時に動かして確かめる。必要なら形式手法(数学的に正しさを確かめる方法)も重ねる
- 最後に少しの文章: 判断が要ることだけを、文章の規則として書く
文章の規則を捨てるという話ではありません。決定的にできるものはコードに移し、文章には判断が要るものだけを残す、という並べ方です。
Grok Bot のチームが実際にしていること
講演の文字起こしと主催者ページの説明で確かめた範囲の、具体的なやり方です(下の3つ目・5つ目・6つ目は主催者ページの説明だけによります)。
- 書かせたくない書き方を、禁止にする: React の
useEffect(画面の部品で副作用を書くための仕組み)を、製品のコードでは禁止しました。フレームワーク(Dune)の一部の API の中でだけ使えるようにしています - コメントの約99%を禁止する: コメントは古くなりやすいためです
- 境界をチェックで守る: アプリの部分ごとにディレクトリを分け、依存の分析と lint で、越えてはいけない境界を守らせています
- エラーの文で直し方を教える: lint が違反を見つけたときのメッセージに直し方を書き、エージェントが読んで元の問題に戻れるようにしています
- 動かして確かめる: Chrome DevTools Protocol などのデバッグの道具で、エージェントがアプリを動かして中身を見られるようにしています。一部では TLA+ や Lean(形式手法の道具)も使っています
- リリース後も自動で確かめる: 安定版をおよそ1日1回出しています。そのたびに、Cursor を使った仕組みがユーザーのようにアプリを操作してバグを探し、見つけたバグごとに修正の PR を開いて、自動でマージしています
講演ページによると、信頼の基準は「寝ている間に、エージェントにマージさせてよいと思えるか」という問いです。また、目の前のコーディングの繰り返しが信頼できるようになってから、外側の自動化に進む順番だと説明されています。
Claude Code に置き換えると:CLAUDE.md は「文脈」、hooks と permissions は「仕組み」
講演と近い考え方が、Claude Code の公式ドキュメントにも書かれています(2026年11月17日に確認。ドキュメントのバージョンの記載は確かめていません)。
- CLAUDE.md: 会話の始めに毎回読み込まれますが、扱いは「文脈」で、強制される設定ではありません。何があっても止めたい操作には、PreToolUse の hook を使うよう案内されています。指示は具体的で短いほど守られやすい、とも書かれています
- hooks: Claude Code の決まった時点で、自分で決めたシェルコマンドを実行する仕組みです。公式ドキュメントは「決定的な制御」と説明しています。AI が実行するかどうかを選ぶのではなく、決めた動作が必ず起きます。PreToolUse の hook は、道具の呼び出しの前に実行され、止めることもできます
- permissions: 許可の規則は deny(拒否)→ ask(確認)→ allow(許可)の順に評価されます。allow で deny の例外は作れません。ファイルを読ませないときは、
Read(./.env)のような Read の deny 規則を書きます(.claudeignoreは効きません)
講演の3つの層に当てはめると、次のようになります。この対応は、せとうちAI の整理です。
| 講演の層 | Claude Code で近いもの | 向いていること |
|---|---|---|
| 決定的な層 | hooks(シェルコマンドのもの)、permissions の deny、lint・型チェック | 毎回必ず止めたい・必ず実行したいこと |
| 検証 | テストの実行、アプリを動かして結果を見ること | 変更が効いたかを確かめること |
| 少しの文章 | CLAUDE.md、スキルの説明 | 判断が要ること、背景の説明 |
注意点もあります。公式ドキュメントによると、Bash の deny 規則は、Claude が書いたコマンドの文字列に当てはまるものです。別の書き方の呼び出しには当たらないため、「セキュリティの境界ではない」とされています。厳しく止めたいときは、サンドボックスも合わせて使うよう案内されています。また hooks にも、AI のモデルに判断させる種類(prompt-based・agent-based)があります。決定的なのは、シェルコマンドの hooks です。
設定の具体例は、Claude Code のセキュリティ設定の記事で扱っています。会社で全員に同じ設定を配る方法は、Claude Code を会社で導入する記事にまとめています。
同じ間違いが2回出たら:仕組みにするかを決めるチェックリスト
講演の考え方をもとに、せとうちAI が作った振り分けのチェックリストです。2回目に同じ間違いが出たときに、上から順に確かめます。
- [ ] その操作をさせなければ済むか: 済むなら、permissions の deny で止める(例: 読ませたくないファイル)
- [ ] 機械的に判定できるか: 「このファイルを書き換えたら」「この書き方があったら」のように条件で決まるなら、hook・lint にする
- [ ] 止めたときに、直し方を伝えられるか: エラーの文に「代わりにこうする」を書く(講演の、lint のメッセージで直し方を示す工夫と同じ考え方)
- [ ] 結果を動かして確かめられるか: テストや、実際に動かした画面・出力を見る手順を決める
- [ ] 判断が要るか: 状況によって正解が変わるものだけ、CLAUDE.md などの文章に短く書く
- [ ] 文章で書いた規則が、2回以上破られていないか: 破られているなら、もう一度上から考え直す
エンジニアでない人が業務でAIエージェントを使う場合も、考え方は同じだと私たちは考えます。たとえば「この表のこの列は書き換えない」は、お願いの文章より、書き換えられない設定にするほうが確実だと考えます。
合わない場合・気をつけること
- 規模と前提が違う: 講演は、10月に約227人が PR を出し、自作のフレームワークまで持つチームの話です。少人数の会社や、コードを書かない業務にそのまま当てはまるとは限りません
- 仕組みを作る手間がかかる: lint のルールや hooks を書くには、それなりの知識と時間が要ります。すべての間違いを仕組みにする必要はなく、繰り返し出るものから始めるのが現実的だと考えます
- 数字を目標にしない: PR の数や revert の割合は、そのチームの体験談です。自分たちの目標の数字にはしないでください
- AI 任せにしない: 講演でも、信頼は確かめながら少しずつ広げる前提です。AI に書かせたコードの安全面の確認は、生成AIに書かせたPHPのレビュー手順の記事も参考にしてください
よくある疑問
CLAUDE.md にはもう何も書かなくてよいのですか?
いいえ。CLAUDE.md は、毎回読み込まれる文脈として役に立ちます。公式ドキュメントも、具体的で短い指示ほど守られやすいとしています。講演の考え方でも、判断が要ることは文章で書きます。変わるのは、「必ず守らせたいこと」を文章だけに頼らない、という点です。
講演の「11,000件」「0.5%」は、AI のコードの品質が高い証拠ですか?
そうとは言えません。チーム自身が示した数字で、第三者の検証はありません。revert の割合は、取り消されたかどうかだけを数えたものです。
動画はどこで見られますか?
YouTube で公開されています(下の「出典」)。英語の講演です。この記事の引用は講演の文字起こしと主催者ページで確かめたもので、動画の音声とは照らし合わせていません。
まとめ
- Lauren Tan 氏の講演の要点は「同じ間違いは、規則に1行足すより、決定的なチェックにする」こと
- 順番は「決定的な層(コード・lint)→ 検証 → 少しの文章」。文章は判断が要ることに絞る
- 講演の数字(前の月にチームで約11,000件の PR、revert 約0.5%)はチーム自身の体験談。「トークンの約7割」は別の人の数字
- Claude Code では、CLAUDE.md は文脈、hooks(シェルコマンドのもの)と permissions の deny は決定的に働く(2026年11月17日に確認)
- まずは、2回目に出た間違いを「仕組みにできるか」で振り分けることから始められる
Claude Code などのAIエージェントのできること・向いている人は、AIエージェントの一覧で紹介しています。
この記事で扱うAIエージェント
- Claude Code
Anthropicが提供する、開発を任せるAIエージェントです。日本語で指示すると、ファイルを読み書きし、コマンドを実行しながら、開発やデータ整形などの作業を進めます。SETODEZAのエンジニアが、実際の開発の現場で使っています。
関連記事
最新ニュース·2026.10.17
AIで情報が漏れるって本当? 2026年の3つの事例に共通する原因
ガイド·2026.10.30